Visualisations de Kaamelott Soundboard
Le projet Kaamelott soundboard est très rigolo. Et il l'est encore plus quand on voit que les métadonnées sont encodées en json, prêtes à être utilisées.
Il m'en faut pas plus pour occuper mon samedi soir : explorons les données que la communauté a produite !
Les codes utilisés pour générer ces visualisations sont dans ce dépôt. Vous noterez, au chargement de la page, l'usage de plotly, une lib python plutôt sympa orientée web pour l'affichage de graphiques interactifs. Je l'utilise surtout pour les sankey plot, mais dans ce billet, on va aussi avoir une heatmap et des barres interactives.
L'inconvénient se mesure à 2 Mo par graphique, donc oui, plotly c'est à la fois un truc de bourgeois citadin et une forme de foutage de gueule pour tout ceux qui n'ont pas la fibre. Charmant.
Répartition des citations
Première étape, étudier la répartition des citations récupérées. Ce sera utile pour ceux qui chercherais des épisodes potentiellement riches en citations encore non intégrées (il y a une liste vivante ici).
En utilisant quelques lignes de python, on peut obtenir ça :
```genmark global-env=True def plot(fname:str): print(open(f'content/images/kaamelott/{fname}.htm').read()) print(f"
')
```genmark global-env=True
plot('citation-count-heatmap')
Certains épisodes sont de toute évidence plus «citables» que d'autres ; le Livre I est clairement le plus exploré actuellement.
Bien sûr, ce soundboard est un travail collaboratif encore loin d'être terminé, donc les biais sont nombreux : la tendance à intégrer les citations de tout un épisode à la fois, par exemple.
Nuage de mots
Quels sont les mots les plus utilisés dans les citations ? Faisons un nuage de mot avec wordcloud :

J'ai simplement aggrandit l'image du compte twitter officiel de Kaamelott où j'ai accentué les bords et le différentiel de couleur.
Le résultat est assez plat : comparé à d'autres nuages de mots dans d'autres contextes, aucun mot ne semble véritablement ressortir. Mention spéciale à «con», il faut lui reconnaître un certain succès, et surtout à «hein» qui a mon grand plaisir se trouve bien grand !
Une certaine richesse du vocabulaire peut-être ? Si tous les personnages disaient cochonnade à chaque réplique, ça se verrait beaucoup ; l'absence d'hyper-représentation de mots me semble être une bonne chose de ce point vue.
En réalité, les mots les plus présents («moi», «dire», «je», «j'ai», «me», «non», «oui», «dit»,…) sont en fait des mots courants dans le parlé.
Ils sont donc filtrés pour laisser plus de place aux autres mots ; la liste de ces mots, nommés «stop words» par les linguistes, dépends partiellement du contexte : j'ai donc ajouté quelques mots à la liste que j'avais récupérée (notamment ceux que j'ai cité).
À partir de quand un mot cesse-t-il d'être une particule du langage, et commence-t-il à être représentatif de Kaamelott ? C'est finalement assez subjectif. Libre à chacun de jouer avec le code et la liste de stop words pour avoir son nuage qui lui semble le plus juste.
Représentation des personnages
L'autre question, c'est évidemment la quantité de citations faisant intervenir chaque personnages… Rien de plus simple !
```genmark global-env=True plot('characters-pie')
Ou, de manière plus prosaïque, parce que [les camemberts ça pue la mort](https://duckduckgo.com/?q=should+i+use+pie+chart), faisons des barres,
et profitons de l'occasion pour enrichir avec les livres d'origine des citations :

```genmark global-env=True
plot('characters-bar')
Sympa ! Sans surprise, c'est le personnage principal qui est le plus prolixe. On observe aussi, en accord avec la heatmap vue plus haut, que la saison 1 est plutôt bien citée comparée aux autres.
Narrative chart
Inspiré d'XKCD, j'ai déjà eu l'occasion de les appliquer à la saga audio Reflet d'Acide. Les sankey graphs ont quelque chose de fascinant, je trouve.
Commençons simplement avec les 10 premiers épisodes du premier livre :
```genmark global-env=True plot('narrative_chart_1_1-10')
(Si vous trouvez le truc un peu fouilli, n'hésitez pas à le réorganiser en cliquant-glissant sur les épisodes/barres verticales)

L'idée est très simple : chaque trace est un personnage, commençant à gauche et se déplaçant vers la droite.
Lorsque deux personnages interviennent dans le même épisode, leur trace s'arrête sur la barre associée. Ils repartent ensuite en direction du prochain épisode qui les accueille.

Il y a deux remarques à prendre en compte.
D'abord, dans les premiers livres, les épisodes de Kaamelott ne sont pas ordonnés selon un fil rouge : il n'y a en fait aucun sens *historique* à trouver dans un sankey plot pour ceux-là.
C'est l'inverse des films, séries ou saga, où les personnages sont limités par les contraintes de réalisme
(Aragorn ne peux pas charger les oliphants avec l'armée des morts, tout en défendant Minas Tirith auprès de Pippin),
là où dans Kaamelott, deux épisodes ne sont liés par aucune contrainte de temporalité.
De fait, ce graphe aura beaucoup plus d'intérêt quand de nombreuses citations du dernier livre (et des films :O) viendront compléter les données.

Aussi, ce graphe est très dépendant des citations ; si un personnage n'a aucune répartie intéressante dans un épisode,
probablement ne seront-elles jamais dans les données.

Appliquée à l'ensemble de Kaamelott, le sankey graph est beaucoup plus touffu, mais révèle une forme assez typique :


```genmark global-env=True
plot('narrative_chart_all')
On voit les personnages les plus récurrents qui s'enroulent autour de l'axe principal, et les personnages secondaires qui viennent comme «picorer» dans les épisodes où ils apparaissent.
Graphe d'interaction
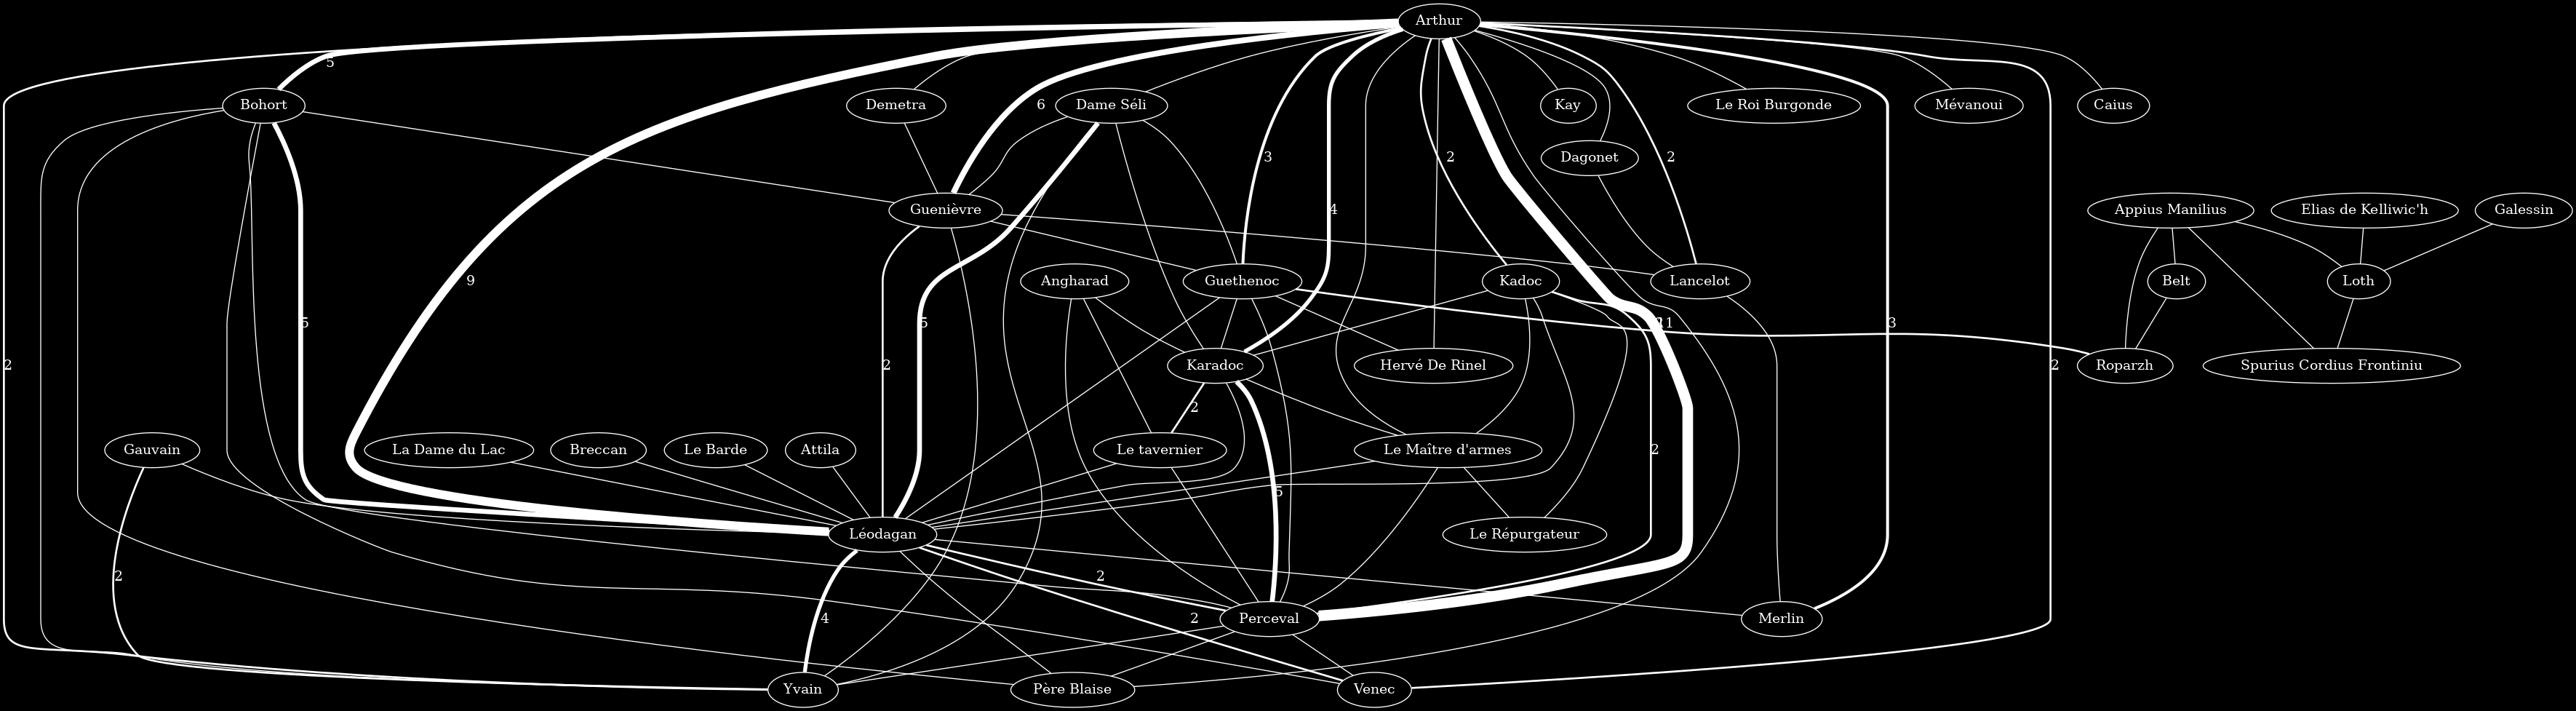
Les données permettent aussi quelque chose de rigolo : savoir quand deux personnages sont présents dans le même épisode. Ça n'indique pas s'ils se parlent l'un à l'autre, mais on peut imaginer donner un graphe d'«interaction» où les personnages sont des nœuds, et où les arcs sont d'autant plus épais que les deux personnages se trouvent souvent dans le même épisode.
Un coups de biseau, et c'est parti !
 [ouvrir en grand]({static}/images/kaamelott/interaction-graph.png)
On sent bien un décalage entre ce qu'on connaît de Kaamelott et les interactions décrites par les données, comme par exemple Élias et Galessin qui se retrouvent tout deux liés uniquement au roi Loth, ou le duo Yvain-Gauvain qui contrairement à son habitude passe assez inaperçu. C'est sans surprise Léodagan et Arthur qui sont au centre du graphe, ainsi que, sans surprise, un gros triangle Arthur-Karadoc-Perceval, gros générateur de répliques mémorables.
Plus encore que les autres, cette représentation souffre grandement du manque de données. Pour résoudre ce problème, outre compléter les données, il existe des techniques de compression comme l'analyse powergraph, qui groupent des nœuds et des arcs en suivant des motifs particuliers (cliques et bicliques).
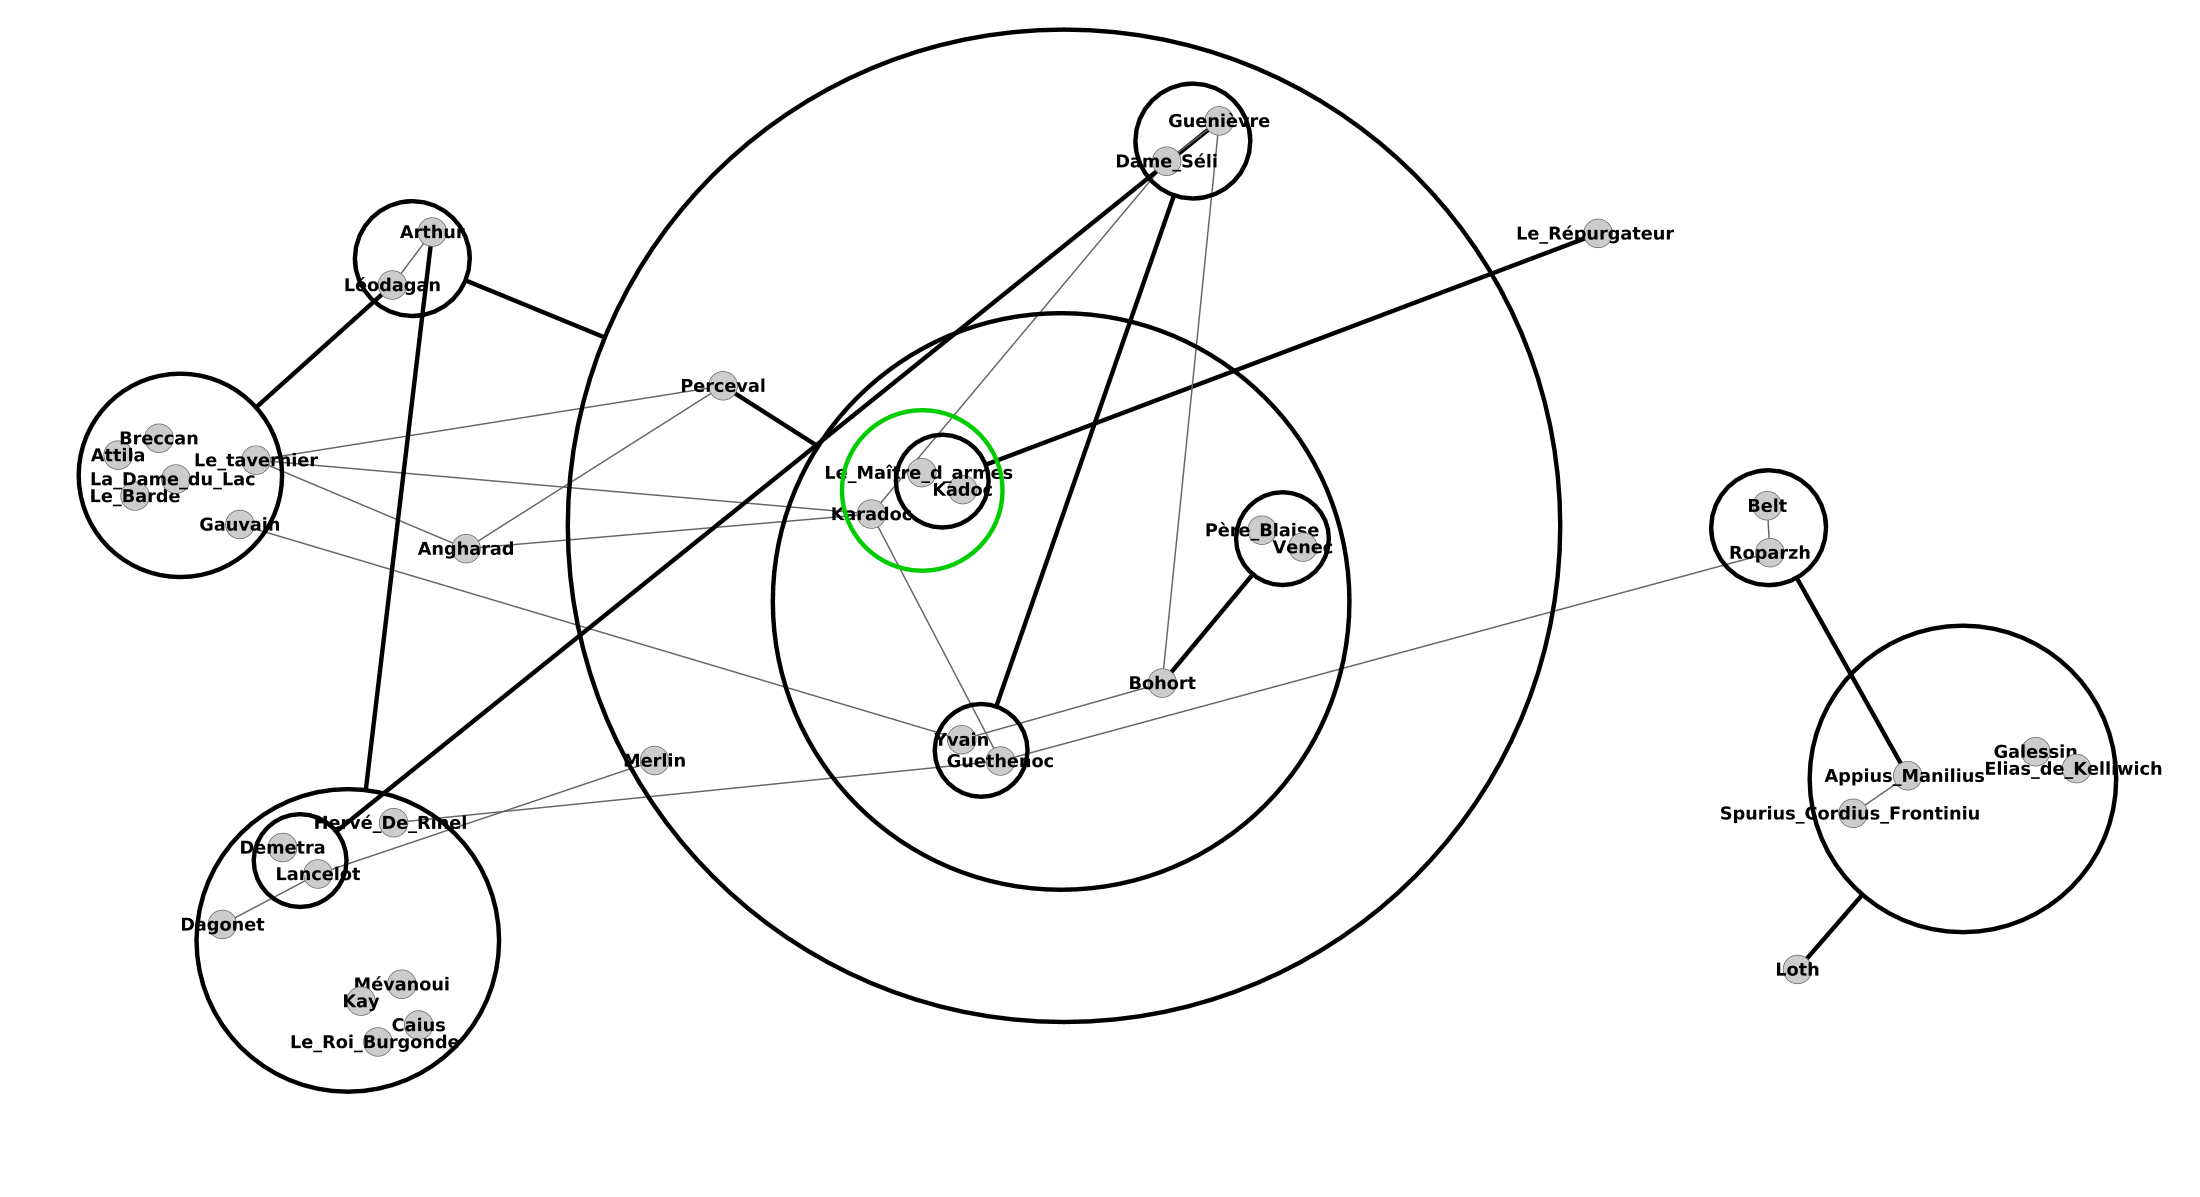
Sur notre graphe d'interaction, cela donne ceci :
 [ouvrir en grand]({static}/images/kaamelott/interaction-graph.bbl.png)
Le principe est le suivant : le programme de compression prend deux ensembles de nœuds qui sont tous reliés 2 à 2 (une biclique), totalisant le plus grand nombre d'arcs (il laisse tomber l'information sur la quantité d'épisode en commun). Dans notre cas, il a commencé par Arthur-Léodagan et Perceval-Merlin-Guenièvre-…-Kadoc. Comme il y a 2 nœud d'un côté, et 11 de l'autre, ça fait 22 arcs couverts par cette biclique. Il a donc créé un power-nœud (cercle noir épais) où il a mit les 2 premiers, et un second où il a mit les 11 autres. Et ils les a relié par un power-arc (trait noir épais qui relie les deux cercles). Et il a répété cette opération, tout en «cassant» des bicliques si elles se chevauchent (parce que les chevauchements, c'est bof). Les arcs gris et fins sont les arcs restants, incompressibles.
Cas particulier, le power-nœud Karadoc-Maître d'armes-Kadoc est en vert, car il s'agit d'une clique : chacun de ces trois personnages intéragit avec les deux autres. D'autres cliques existent, mais le programme à favorisé des bicliques cassant ces cliques, car les bicliques couvraient plus d'arcs.
D'ailleurs, cette seule clique est très centrale dans le graphe : nous découvrons ainsi une info qui était plus difficile à voir que dans la version «plate» du graphe : ces trois personnages sont partout, extrêmement centraux dans les citations. Arthur et Léodagan partagent une place très proche, ce qui corrobore leur rôle central dans le graphe plat. On peut aussi facilement voir les spécifiques à chacun de ces deux rois, dans les power-nœuds à gauche et en bas à gauche (Attila est spécifique à Léodagan, Lancelot à Arthur…).
La conséquence immédiate, c'est que les nœuds sont groupés ensembles lorsqu'ils partagent des voisins en commun.
L'avantage, outre que la représentation du graphe est plus compréhensible (une fois qu'on a l'habitude), c'est que ladite représentation est résistante au bruit, notamment les arcs en trop. Dans notre cas, comme il manque des arcs, c'est moins efficace. Pour trouver les structure importante avec ce genre de technique, il faudrait donc s'intéresser aux quasi-motifs : des motifs presques complets, où il manque quelques arcs. Je ferais ça quand j'aurais le temps.
Raccourcisseur de citation
Pour ceux qui connaissent ASP, cette partie est l'occasion d'en faire un peu.
L'objectif est le suivant :
sachant l'ensemble des citations (notamment leur nom de fichier), déterminer un nom raccourcis pour chacune d'elle de telle manière que le nom raccourcis soit unique, minimal, et identifie au mieux la citation.
Par exemple, la citation «est-ce qu'on peut s'en servir pour donner de l'élan à un pigeon ?»
est nommée est_ce_que_peut_servir_elan_pigeon.
Une version minimale et toujours claire pourrait être elan_pigeon, voir même
juste un seul de ces deux mots si il n'est pas déjà utilisé par une autre citation.
La solution proposée ici pour ce problème est constituée de deux étapes :
- chopper l'ensemble des citations dont le titre possèdre un mot spécifique, i.e. utilisé uniquement par cette citation
- pour les autres, demander à ASP de trouver des associations minimales et uniques
La première étape est évidemment là pour simplifier la vie au solveur.
Cette solution est implémentée dans ce dépôt.
Données, méthode
Les données sont extraites en python, et encodées pour ASP sous la forme d'atomes word/2,
tel que word(N,W) indique que le fichier/citation N contient/utilise le mot W.
ASP devra alors simplement nous dire quelle est sa sélection, sous la forme d'atomes selword(N,W),
où N est le fichier/la citation, et W un mot à utiliser dans son identifiant unique.
La méthode est assez simple : deux citations doivent avoir des ensemble de mots dans leur identifiants uniques strictement différents, mais le plus petit possible. C'est l'occasion de faire de la minimisation.
Une solution
Voilà celle utilisée actuellement dans le dépôt :
% ENTRÉE: word(C,M): la citation C utilise le mot M
% SORTIE: selword(C,M): la citation C doit utiliser le mot M dans son uid

% Choix d'au moins un mot pour chaque citation.
1{ selword(N,W): word(N,W) } :- word(N,_).

% Écarter les modèles où deux citations utilise les même mots.
:- selword(N1,_) ; selword(N2,_) ; N1!=N2 ; selword(N1,X): selword(N2,X) ; selword(N2,Y): selword(N1,Y).

% Minimisation du nombre de selword.
nb_selword(N) :- N={selword(_,_)}.
#minimize{N:nb_selword(N)}.
On notera que rien n'empêche une citation de posséder comme identifiant unique un sous-ensemble strict des mots d'une autre citation. Il n'y a en théorie rien de mal avec ça, alors on peut probablement laisser comme ça.
Résultats
Comme montré ici, il existe une solution où chaque citation est réduite à un mot. Super ! Ça corrobore l'hypothèse vue plus haut sur la diversité du vocabulaire.
Améliorations
Outre l'inclusion dans le site (il faudra avoir un bon résultat final pour ça), il y a une amélioration notable : quel mot spécifique à une citation doit être conservé ?
En effet, à l'étape de détection des mots spécifiques, on observe que parfois ces mots sont peut représentatifs de la citation ; il s'agit en fait d'une particule ou d'un petit mot trouvé nul part ailleurs, plus par chance que par réel sens, et rien n'empêche le code actuel de faire ce choix.
Exemple : la citation «Ils se barrent en mission pendant 3 mois, et ils reviennent avec une anguille ?» possède 5 mots spécifiques : pendant, mission, reviennent, barrent, anguille. De part l'application d'une règle arbitraire que j'ai décidé d'implémenter au pied levé, sans plus de réflexion, c'est actuellement «revienne» qui est choisi.
La règle arbitraire implémentée au moment d'écrire ce billet est de privilégier les mots contenant un «z», et prendre celui le plus long.
En vérité, en regardant les résultats, on devrait trouver un système de règles plus fin, peut-être à base d'étude des parties du discours.
Par exemple, préférer les noms commun qu'on ne trouve rarement dans un grand corpus de texte ?
Conclusion
Voilà qui clôt l'article pour le moment. Celui-ci étant vivant, si d'autres visualisations sympa sont ajoutées au dépôt, elles seront ajoutées ici aussi, pour le plaisir des yeux.
Vivement les prochaines citations, car chacune d'entre elles peut transformer le graphe d'interaction et verdir la heatmap.
Sur ce, à plus tard !